Giám sát chủ động VPS với DNT SaaS FindMe VPS
Bạn mở MetaTrader 5 lúc 7 giờ sáng. Chart vẫn nhảy giá, nút AutoTrading vẫn xanh, log không có dòng đỏ nào. Nhưng lịch sử giao dịch trống trơn từ 2 giờ 47 phút sáng. Không ai gọi bạn. Không có email nào. Không có thông báo nào. Bạn phát hiện ra sự cố bằng mắt của mình, sau gần bốn tiếng đồng hồ.
Đó là giám sát bị động: bạn là người kiểm tra, và máy chỉ trả lời khi bạn hỏi.
Giám sát chủ động đảo ngược hoàn toàn vai trò đó. Hệ thống tự đo, tự so với ngưỡng, và tự gọi bạn khi phát hiện bất thường. Bạn không phải là người đi tìm sự cố nữa. Bạn là người nhận tin và xử lý.
Bài này nói về cách DNT SaaS FindMe VPS làm việc đó, nhưng trước hết nói về lý do vì sao cách giám sát theo kiểu truyền thống hay bỏ sót đúng những sự cố đắt tiền nhất.
Nghịch lý: VPS vẫn xanh, bot vẫn chết
Hãy nhìn vào bảng điều khiển của nhà cung cấp VPS trong lúc bot đã chết. Bạn sẽ thấy những con số rất yên tâm: uptime 99,98 phần trăm, độ trễ mạng vài chục mili giây, CPU dưới 10 phần trăm, RAM dùng chưa tới một nửa, ổ đĩa còn trống nhiều.
Không một chỉ số nào trong đó báo rằng bot của bạn đã ngừng làm việc.
Đó là điểm mấu chốt. Uptime trả lời câu hỏi máy có điện hay không. Nó không trả lời câu hỏi tiến trình giao dịch có còn hoạt động hay không. Một chiếc VPS hoàn toàn khỏe mạnh vẫn có thể đang chạy một terminal MT5 đã mất kết nối tới sàn, hoặc đang chạy một EA đã thoát khỏi vòng lặp xử lý vì một ngoại lệ không được bắt.
Nghịch lý nằm ở chỗ: càng nhìn vào những chỉ số hạ tầng, bạn càng dễ yên tâm sai. Máy càng ổn định thì bảng điều khiển càng đẹp, và càng dễ khiến bạn không đi kiểm tra lớp thật sự quyết định kết quả giao dịch.
Có bốn kiểu đứt gãy thường xảy ra trong khi mọi chỉ số hạ tầng vẫn bình thường.
Thứ nhất, mất kết nối tới sàn. Terminal vẫn mở, vẫn hiển thị giá cũ, nhưng không gửi được lệnh.
Thứ hai, mất quyền giao dịch. Nút AutoTrading bị tắt, do một thao tác vô tình, do hộp thoại xác nhận của một EA khác, hoặc do terminal khởi động lại và mặc định trả về trạng thái tắt.
Thứ ba, nguồn dữ liệu lịch sử không còn đủ. EA cần dữ liệu để tính chỉ báo, nhưng dữ liệu bị hụt do mất kết nối trong một khoảng thời gian trước đó.
Thứ tư, lớp logic trong EA dừng lại. EA không có lỗi cú pháp, không bị tắt, nhưng một điều kiện phụ thuộc vào biến cấu hình đã chặn toàn bộ nhánh vào lệnh. Kiểu này không để lại dấu vết nào trừ khi bạn tự viết log cho nó.
Bốn kiểu này nằm ở ba tầng khác hẳn nhau, và cách phát hiện cũng khác hẳn nhau.
Ba tầng của một hệ thống bot MT5
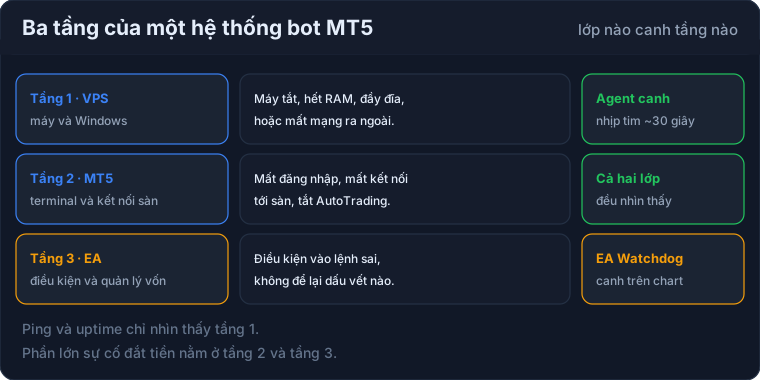
Muốn giám sát chủ động, trước tiên phải chia hệ thống thành các tầng rõ ràng, vì mỗi tầng hỏng theo một cách riêng và để lại một loại dấu hiệu riêng.
Tầng một là máy và hệ điều hành. VPS còn bật hay không, RAM có bị ăn hết hay không, ổ đĩa có đầy file log hay không, mạng ra ngoài có thông hay không, và máy có vừa khởi động lại đột ngột hay không. Đây là tầng duy nhất mà các công cụ giám sát uptime thông thường thật sự nhìn thấy.
Tầng hai là terminal MT5 và đường kết nối tới sàn. Terminal có đang chạy không, có đăng nhập đúng tài khoản không, kết nối tới máy chủ của sàn có còn sống không, dữ liệu giá có đang được cập nhật không, và trạng thái giao dịch tự động có đang bật không.
Tầng ba là lớp logic của bạn: EA, điều kiện vào lệnh, quản lý vốn, và các quy tắc riêng bạn viết. Tầng này không có chỉ số hạ tầng nào phản ánh được, và cũng là tầng không thể giám sát nếu chỉ dùng ping.
Ba tầng này giải thích vì sao một hệ thống giám sát chỉ nhìn tầng một sẽ luôn bỏ sót phần lớn sự cố. Khi khách hàng hỏi vì sao bot chết mà VPS vẫn xanh, câu trả lời gần như luôn nằm ở tầng hai hoặc tầng ba.
Những gì giám sát bị động không nhìn thấy
Giám sát bị động có ba dạng phổ biến, và cả ba đều có điểm mù giống nhau.
Dạng thứ nhất là ping hoặc kiểm tra HTTP định kỳ. Cách này xác nhận máy còn trả lời. Nhưng một máy trả lời ping hoàn toàn có thể đang chạy một terminal mất kết nối sàn từ ba tiếng trước đó. Ping nói về đường mạng, không nói về giao dịch.
Dạng thứ hai là theo dõi tài nguyên: CPU, RAM, ổ đĩa. Đây là chỉ số tốt để chẩn đoán sau khi biết có sự cố, nhưng rất kém trong vai trò cảnh báo trước. Đa số trường hợp EA dừng lại vì logic đều ăn CPU rất thấp. Máy chạy êm hơn bình thường, còn bảng điều khiển thì đẹp hơn bình thường.
Dạng thứ ba là kiểm tra thủ công. Mở điện thoại, xem chart, xem Telegram có tín hiệu hay không, xem lịch sử giao dịch có dòng mới hay không. Cách này hiệu quả khi bạn còn thức, còn nhớ, và còn mở máy. Nó thất bại đúng vào lúc cần nhất: 3 giờ sáng.
Cách đo uptime sao cho không tự lừa mình là một chủ đề đủ dài để viết riêng — xem Đo uptime bot cho đúng.
Có một vấn đề tinh tế hơn nữa. Một số hệ thống tự kiểm tra bằng cách gọi chính dịch vụ của mình rồi thấy dịch vụ trả lời, và kết luận mọi thứ bình thường. Nhưng tín hiệu đó do hệ thống giám sát tự tạo ra, không do lớp giao dịch thật phát ra. Đó là kiểu tự lừa mình. Muốn giám sát có ý nghĩa, tín hiệu phải xuất phát từ chính lớp đang làm việc.
Nhịp tim: chỉ số đầu tiên cần theo dõi
Cách làm đúng là để lớp giao dịch tự phát ra một tín hiệu định kỳ khi nó còn đang làm việc. Tín hiệu đó thường được gọi là nhịp tim.
Nhịp tim hoạt động theo nguyên tắc đơn giản. Nếu bot còn sống và còn làm việc, nó phát tín hiệu đều đặn theo chu kỳ đã định. Nếu tín hiệu ngừng xuất hiện quá một khoảng thời gian, nghĩa là có chuyện ở chính lớp phát nhịp.
Điểm mạnh của nhịp tim nằm ở chỗ nó không đo gián tiếp. Nó không suy luận từ CPU, không suy luận từ ping. Nó đòi hỏi chính tiến trình giao dịch phải nói lên rằng nó vẫn đang làm việc. Một tiến trình bị treo sẽ không phát nhịp, và đó là tín hiệu trung thực nhất bạn có thể có.
DNT SaaS FindMe VPS dùng chu kỳ nhịp khoảng 30 giây cho lớp agent. Con số này là kết quả của một phép cân đối. Ngắn hơn nữa thì nhạy hơn nhưng dễ báo động giả khi mạng chớp trong vài giây. Dài hơn thì bớt nhiễu nhưng thời gian phát hiện sự cố cũng dài ra. Khoảng 30 giây đủ nhanh để bạn còn kịp xử lý trong một phiên đang mở, và đủ chậm để không phản ứng với những rung động vô hại của đường truyền.
Một chi tiết quan trọng: mất một nhịp không có nghĩa là bot đã chết. Hệ thống phải chờ thêm để phân biệt giữa một lần mạng chớp và một lần chết thật. Nếu báo ngay khi mất một nhịp, bạn sẽ nhận rất nhiều cảnh báo vô nghĩa, và đến lần thứ hai mươi thì bạn sẽ bắt đầu bỏ qua chúng. Một hệ thống cảnh báo bị bỏ qua còn tệ hơn không có cảnh báo, vì nó tạo cảm giác an toàn giả.
Kiến trúc DNT SaaS FindMe VPS: hai lớp canh chừng
Sản phẩm được xây theo hai lớp, mỗi lớp canh một tầng khác nhau của hệ thống. Cách chia này không phải để cho phức tạp, mà vì một lớp không thể làm tốt cả hai việc.
Lớp thứ nhất là Agent chạy trên VPS. Đây là một tiến trình nền, chạy song song với terminal. Nó đo tình trạng máy, theo dõi terminal và đường kết nối, và gửi nhịp về máy chủ FindMe theo chu kỳ. Agent không cần mật khẩu sàn của bạn. Nó không đọc chiến lược của bạn. Nó không gửi lệnh. Nó chỉ trả lời một câu hỏi: lớp vận hành còn làm việc hay không.
Lớp thứ hai là EA Watchdog gắn trên chart. Đây là một EA riêng, chạy cạnh EA giao dịch của bạn, canh đúng lớp mà agent không nhìn thấy: trạng thái giao dịch tự động, chất lượng đường kết nối trong lúc giao dịch, dữ liệu giá có được cập nhật đều hay không, và tình trạng sống còn của EA mà bạn đang chạy.
Điểm quan trọng là cả hai lớp đều chỉ đọc. Chúng không can thiệp vào lệnh, không thay đổi tham số, không tự ý tắt hay mở giao dịch. Việc quyết định vẫn nằm ở bạn, sau khi bạn nhận được thông báo.
Phần còn lại nằm trên máy chủ FindMe: nhận nhịp, so với ngưỡng, ghi lại lịch sử, và gửi thông báo qua Telegram. Toàn bộ phần này chạy ngoài VPS của bạn, nên nếu VPS mất mạng thì hệ thống phía ngoài vẫn phát hiện được sự im lặng đó.
Cách chia hai lớp này được phân tích kỹ hơn, kèm lý do vì sao chỉ canh máy là chưa đủ, trong bài 2 lớp canh chừng: Agent và EA Watchdog.
Một vòng phát hiện diễn ra thế nào
Hiểu một vòng phát hiện giúp bạn đặt kỳ vọng đúng về tốc độ và về giới hạn.
Đầu tiên, agent gửi nhịp theo chu kỳ khoảng 30 giây, kèm vài chỉ số phụ về tình trạng máy và terminal. Máy chủ FindMe ghi nhận thời điểm nhận được.
Nếu quá một khoảng chờ mà chưa có nhịp mới, hệ thống không kết luận ngay. Nó chờ thêm để loại trừ trường hợp đường truyền chớp trong vài giây, vốn rất phổ biến và tự khỏi.
Nếu tình trạng im lặng kéo dài, hệ thống gửi cảnh báo qua Telegram. Nội dung cảnh báo nêu rõ máy nào, thời điểm bắt đầu im lặng, và triệu chứng cuối cùng ghi nhận được trước đó. Ba thông tin này quan trọng như nhau: biết có sự cố là chưa đủ để hành động, bạn cần biết nó ở đâu và bắt đầu từ lúc nào.
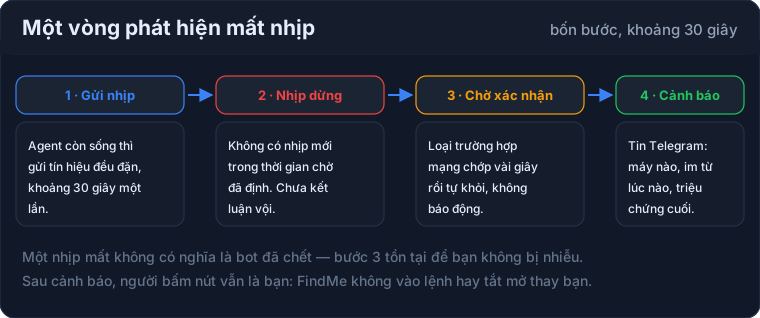
Sau cảnh báo, bạn xử lý theo tình huống. Nếu là VPS vừa khởi động lại, bạn khởi động lại terminal. Nếu là mất kết nối sàn, bạn đăng nhập lại. Nếu là EA bị tắt giao dịch tự động, bạn bật lại. FindMe không bấm thay bạn, vì đó là vùng quyết định của bạn trên tài khoản của bạn.
Một nguyên tắc cần nói rõ để bạn không kỳ vọng sai: đây là hệ thống cảnh báo và khởi động lại có xác nhận, không phải hệ thống tự động vào lệnh thay bạn. Cảnh báo đến trong khoảng 30 giây kể từ khi nhịp bị coi là mất. Phần xử lý sau đó phụ thuộc vào bạn.
Thông báo Telegram: có việc để làm, không phải tin nhắn cho vui
Kênh thông báo được chọn là Telegram vì ba lý do thực dụng: nó đến đúng thiết bị bạn luôn mang theo, nó không phụ thuộc vào việc bạn có mở email hay không, và nó giữ được một dòng thời gian để bạn tra lại sau này.
Nhưng chọn kênh chỉ là một nửa của vấn đề. Nửa còn lại là tần suất. Một hệ thống gửi quá nhiều thông báo sẽ bị bạn lọc bằng phản xạ, và khi đó thông báo thật cũng bị lọc theo.
Vì vậy thông báo của FindMe được thiết kế theo nguyên tắc: mỗi tin phải tương ứng với một việc bạn có thể làm. Nếu một tình huống không đòi hỏi hành động nào, nó thuộc về lịch sử chứ không thuộc về điện thoại của bạn. Những thay đổi nhỏ tự khỏi sẽ nằm trong nhật ký để tra cứu, không đẩy thành tin nhắn lúc 3 giờ sáng.
Bốn chỉ số nên theo dõi và ngưỡng gợi ý
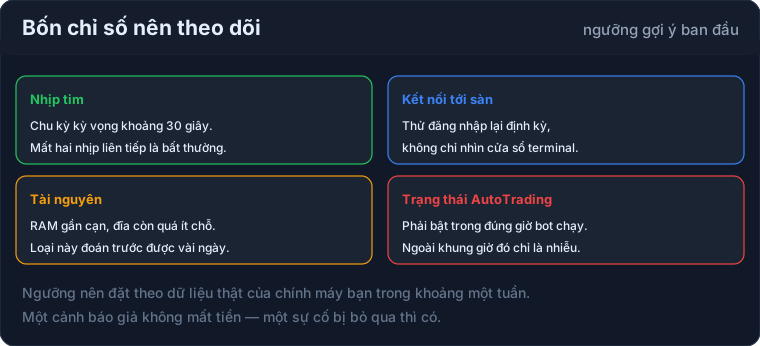
Dưới đây là bốn chỉ số có giá trị thực tế nhất, kèm cách đặt ngưỡng ban đầu. Bạn nên xem đây là điểm xuất phát, không phải con số cố định cho mọi cấu hình.
Chỉ số thứ nhất là nhịp tim. Chu kỳ kỳ vọng khoảng 30 giây. Thực tế nên coi là bất thường khi mất hai nhịp liên tiếp. Đặt ngưỡng ở mức một nhịp sẽ tạo ra quá nhiều cảnh báo giả trên những đường truyền hay chớp.
Chỉ số thứ hai là trạng thái kết nối tới sàn. Không chỉ hỏi terminal còn chạy hay không, mà hỏi nó còn nói chuyện được với máy chủ của sàn hay không. Một phép thử đăng nhập định kỳ cho kết quả rõ ràng hơn nhiều so với việc chỉ nhìn vào tiêu đề cửa sổ terminal.
Chỉ số thứ ba là tài nguyên theo hướng tài nguyên thật sự cản trở công việc. RAM ở mức gần cạn, hoặc ổ đĩa còn lại dưới một ngưỡng an toàn đủ để terminal đang chạy không ghi được dữ liệu. Đây là loại sự cố có thể đoán trước vài ngày, nên cảnh báo sớm có giá trị.
Chỉ số thứ tư là trạng thái giao dịch tự động trong những khung giờ bạn kỳ vọng bot làm việc. Nếu bot của bạn chỉ chạy trong phiên London và New York, thì một cảnh báo khi trạng thái này tắt trong đúng khung giờ đó là tín hiệu có ích. Cùng cảnh báo đó ngoài khung giờ sẽ là nhiễu.
Đặt ngưỡng thế nào để không bị nhiễu
Cách đặt ngưỡng đúng không phải là chọn con số nghe có vẻ hợp lý, mà là quan sát dữ liệu thật của chính bạn trước.
Hãy để hệ thống chạy ở chế độ ghi nhận trong khoảng một tuần, ghi lại nhịp tim, độ trễ kết nối và mức tài nguyên trong điều kiện bình thường. Sau đó đặt ngưỡng dựa trên dải dao động thật đó.
Ví dụ, nếu một tuần dữ liệu cho thấy độ trễ kết nối tới sàn thỉnh thoảng lên tới vài trăm mili giây trong vài phút mà không gây sự cố nào, thì đặt ngưỡng ở mức đó sẽ chỉ tạo ra cảnh báo vô nghĩa. Ngưỡng nên nằm ở vùng mà bạn thật sự muốn biết.
Sau khi đặt, hãy siết dần chứ đừng nới ngay. Một cảnh báo giả không làm mất tiền. Một sự cố bị bỏ qua thì có thể.
Cuối cùng, hãy kiểm tra định kỳ xem bạn có còn hành động được từ những cảnh báo đang nhận hay không. Nếu một loại cảnh báo xuất hiện mười lần mà bạn không làm gì cả mười lần đó, hoặc là ngưỡng sai, hoặc là loại cảnh báo đó không cần thiết.
Nhật ký: thứ bạn cần khi sự cố đã xảy ra
Cảnh báo giải quyết việc phát hiện. Nhật ký giải quyết việc hiểu nguyên nhân, và đây là phần bị xem nhẹ nhất trong các hệ thống giám sát.
Khi bot ngừng làm việc, câu hỏi thật của bạn không phải là có sự cố hay không, mà là nó bắt đầu từ lúc nào và vì sao. Hai thông tin này quyết định cách bạn sửa. Nếu nguyên nhân là VPS vừa khởi động lại, bạn khởi động lại terminal và xong việc. Nếu nguyên nhân là mất kết nối sàn trong lúc đang giữ một vị thế, bạn cần biết chính xác khoảng thời gian mất kết nối để đối chiếu với lịch sử lệnh, vì đó là lúc quản lý vị thế của bạn bị mù.
Một nhật ký đủ dùng phải trả lời được ba câu hỏi theo thứ tự thời gian: lúc nào nhịp tim ngừng, lúc nào nó trở lại, và giữa hai mốc đó hệ thống ghi nhận được gì. Có ba mốc này, bạn mất vài phút để hiểu sự cố. Không có chúng, bạn mất cả buổi sáng để đoán, và thường đoán sai vì sự cố dễ xảy ra nhất lại nằm ở lớp không để lại dấu vết nào.
Đây cũng là lý do FindMe lưu lịch sử nhịp và các sự kiện thay vì chỉ gửi cảnh báo rồi quên. Cảnh báo chỉ có giá trị đúng vào lúc nó đến. Nhật ký còn giá trị trong nhiều tháng sau đó, nhất là khi bạn cần biết một sự cố đã từng xảy ra hay chưa để loại trừ nó khỏi danh sách nghi vấn.
Ba tình huống thật và cách hệ thống phản ứng
Tình huống thứ nhất: VPS khởi động lại đột ngột lúc 2 giờ sáng do nhà cung cấp bảo trì. Terminal MT5 đóng, agent mất nhịp. Trong khoảng 30 giây tính từ lúc đủ điều kiện coi là mất nhịp, bạn nhận thông báo qua Telegram với mốc thời gian và tên máy. Bạn mở điện thoại, khởi động lại terminal, và bot trở lại trong vài phút thay vì vài giờ. Kiểu sự cố này phổ biến tới mức có hẳn một bài riêng về nó: VPS bị bảo trì đột ngột.
Tình huống thứ hai: đường truyền của VPS chớp trong vài giây, agent mất đúng một nhịp rồi có lại. Hệ thống ghi nhận vào lịch sử nhưng không gửi cảnh báo. Đây là trường hợp cho thấy vì sao việc chờ thêm là cần thiết: phản ứng với nó sẽ tạo ra hàng chục cảnh báo mỗi tháng mà không có sự cố thật nào.
Tình huống thứ ba: EA vẫn chạy, terminal vẫn kết nối, nhịp vẫn đủ, nhưng điều kiện vào lệnh không còn thỏa mãn vì một lần mất dữ liệu trước đó đã làm hụt dữ liệu lịch sử cho chỉ báo. Đây là kiểu sự cố mà chỉ lớp EA Watchdog trên chart mới phát hiện được, vì không có chỉ số hạ tầng nào thay đổi. Nếu bạn chỉ dùng giám sát uptime, bạn sẽ phát hiện ra sự cố này bằng cách đọc lịch sử giao dịch và tự hỏi vì sao không có lệnh nào.
Ba tình huống này cũng là ba mức độ khác nhau của cùng một câu hỏi: bạn đang canh cái gì, và bằng tín hiệu nào.
Những việc FindMe không làm
Nói rõ giới hạn giúp bạn đánh giá đúng và tránh kỳ vọng sai.
FindMe không cần mật khẩu sàn của bạn, nên không có chuyện hệ thống đăng nhập vào tài khoản và giao dịch thay bạn. FindMe không đọc chiến lược hay tham số riêng trong EA của bạn. FindMe không tự động vào lệnh, không tự động đóng lệnh, và không tự ý thay đổi cấu hình tài khoản.
FindMe không thay bạn ra quyết định. Khi nhận cảnh báo, bạn là người chọn cách xử lý.
Và FindMe không cam kết lợi nhuận. Đây là công cụ vận hành, không phải chiến lược đầu tư. Nó giúp bạn biết sớm hơn rằng hệ thống của mình đang có vấn đề, và giúp bạn rút ngắn thời gian gián đoạn. Phần còn lại vẫn thuộc về chiến lược và kỷ luật của bạn.
Triển khai trong khoảng 15 phút
Quá trình thiết lập được thiết kế để làm một lần, không đòi hỏi kiến thức lập trình.
Bước một, tạo tài khoản. Bản dùng thử bảy ngày không cần thẻ, nên bạn có thể thử trên một VPS thật rồi mới quyết định.
Bước hai, tải agent xuống VPS và chạy bằng một dòng lệnh sau khi tạo mã ghép. Agent làm việc ở chế độ nền, không mở cửa sổ, không cần bạn giữ phiên đăng nhập. Nếu sau này bạn đổi tên miền máy chủ FindMe, có sẵn script cập nhật cấu hình cho agent mà không phải gỡ ra cài lại.
Bước ba, gắn EA Watchdog vào chart đang chạy EA giao dịch của bạn. Đây là bước tùy chọn nhưng nên làm, vì nó là lớp duy nhất canh được tầng logic.
Bước bốn, thử giả lập một sự cố. Cách đơn giản nhất là tắt trạng thái giao dịch tự động trong vài phút, hoặc dừng agent trong vài phút, rồi xem cảnh báo có đến thật hay không. Bước này bị nhiều người bỏ qua, và đó là lý do khi sự cố thật xảy ra, họ không biết hệ thống cảnh báo của mình có hoạt động hay không.
Bước năm, chỉnh ngưỡng sau khi có dữ liệu thật khoảng vài ngày.
Chi phí và cách dùng thử
Giá hiện tại là 20 đô la cho một VPS mỗi tháng. VPS thứ hai cộng thêm 15 đô la. Gói ba VPS là 49 đô la mỗi tháng.
Cách đặt giá này phản ánh đúng cách hệ thống được dùng: phần lớn nhà giao dịch chạy nhiều hơn một tài khoản hoặc nhiều hơn một bot, và chi phí biên cho mỗi VPS tiếp theo thấp hơn chi phí cho VPS đầu tiên.
Nếu bạn chưa quen với con số này, hãy so nó với chi phí của một sự cố. Một đêm bot im lặng có thể làm mất một lệnh đáng giá hơn nhiều tháng phí vận hành, chưa tính tới việc bạn phải bỏ ra vài giờ để tìm nguyên nhân vào sáng hôm sau. Nhưng cũng phải nói thẳng: nếu bạn chỉ chạy một bot nhỏ với tần suất thấp và bạn tự kiểm tra được hằng ngày, giá trị của giám sát tự động sẽ thấp hơn nhiều so với người chạy nhiều tài khoản trong nhiều phiên.
Bạn có thể xem bảng giá đầy đủ và tạo tài khoản dùng thử bảy ngày tại chuyendoiso.digital, mục Bảng giá và Đăng ký. Nếu cần trao đổi trước khi cài, liên hệ Zalo 0934 145 100 hoặc email daotao@huongnghiepdulieu.com.
Cách dùng thử cho đúng
Bản dùng thử bảy ngày chỉ có giá trị nếu bạn cài lên chính VPS đang chạy bot thật, không phải một máy trắng vừa tạo. Trên một máy sạch, hệ thống gần như không bao giờ có gì để báo, và bạn dễ kết luận sai rằng nó không hoạt động.
Hãy chọn tuần dùng thử là tuần bot chạy đủ phiên. Trong tuần đó, nên chủ động tạo ít nhất một lần sự cố giả để kiểm tra đường cảnh báo, và ghi lại thời gian từ lúc tạo sự cố tới lúc nhận được tin nhắn. Con số đó quan trọng hơn mọi lời mô tả, vì nó đo đúng thứ bạn sẽ quan tâm khi có chuyện thật.
Cuối tuần dùng thử, hãy xem lại nhật ký của chính mình trước khi quyết định trả phí. Nếu nhật ký cho thấy hệ thống đã ghi nhận đúng những lần bạn thao tác trên VPS, thì nó cũng sẽ ghi đúng những lần bạn không ở đó.
Câu hỏi thường gặp
Cài đặt có cần mật khẩu sàn không? Không. Agent không cần thông tin đăng nhập sàn của bạn, và hệ thống không đăng nhập vào tài khoản để giao dịch thay bạn.
Có làm chậm EA đang chạy không? Agent chạy như một tiến trình riêng bên cạnh terminal, không can thiệp vào vòng xử lý của EA. EA Watchdog là một EA nhẹ, chạy song song trên cùng chart.
Có cần thuê VPS mới không? Không. Hệ thống chạy trên VPS bạn đang dùng cho bot.
Chạy nhiều VPS, nhiều bot thì thế nào? Mỗi VPS cài một agent và gắn vào cùng tài khoản FindMe. Gói nhiều VPS áp dụng khi bạn quản lý từ hai VPS trở lên.
EA Watchdog có bắt buộc không? Không bắt buộc. Nhưng nếu bạn bỏ nó, bạn chỉ còn lớp canh vận hành, và những sự cố thuộc tầng logic sẽ không được phát hiện. Nếu muốn tự viết một lớp canh chừng tương tự để hiểu cơ chế bên trong, bài EA Watchdog bằng MQL5 có hướng dẫn từng bước.
Nếu VPS mất mạng hoàn toàn thì sao? Đó chính là trường hợp hệ thống phát hiện dễ nhất, vì nhịp tim sẽ ngừng lại hoàn toàn và cảnh báo được gửi từ phía máy chủ FindMe chứ không phải từ VPS của bạn.
Bản dùng thử có cần thẻ không? Không. Bạn dùng thử bảy ngày trước khi quyết định trả phí.
Tổng kết
Giám sát chủ động không phải là mua thêm một bảng điều khiển đẹp hơn. Nó là việc thay đổi người phát hiện sự cố: từ bạn sang hệ thống, và thay đổi thời điểm phát hiện: từ sau khi bạn thức dậy sang trong vòng vài chục giây.
Muốn làm được điều đó, cần ba yếu tố đi cùng nhau. Một tín hiệu trung thực do chính lớp giao dịch phát ra, một hệ thống so ngưỡng đủ hiểu biết để không báo động vô cớ, và một kênh thông báo đến đúng người có khả năng xử lý.
DNT SaaS FindMe VPS được xây quanh ba yếu tố đó, chia thành hai lớp canh chừng: Agent canh tầng vận hành của VPS, và EA Watchdog canh tầng logic giao dịch trên chart. Cả hai chỉ đọc, không vào lệnh, không cần mật khẩu sàn.
Việc còn lại của bạn là một quyết định nhỏ: dành mười lăm phút để cài đặt, hoặc tiếp tục phát hiện sự cố bằng cách mở chart lúc bảy giờ sáng.